AI活用分析
GPT-6 Sol / Lunaは5.6から何が変わった?判断力・料金・Codex比較
目次
GPT-5.6から6へ替えるなら、コードの点数だけでなく「どこまで指示せずに任せられるか」も気になりますよね。この記事では、2026年9月23日時点の公開資料を使い、GPT-6 Sol / Lunaと5.6世代の違いを読み解きます。現在選べる全モデルの比較ではなく、発表時点の世代差を振り返る記事です。
OpenAIはその後、後継のGPT-6.1 Solも案内しています。発表当時、6 Sol / LunaはCodex・ChatGPT Work・API・GitHub Copilotで提供が始まり、通常のChatGPTチャットではPlus / Proでも選べない状況でした。
| 利用場所 | GPT-6 Sol | GPT-6 Luna | 対象・注意点 |
|---|---|---|---|
| 通常のChatGPT | 未提供 | 未提供 | ChatGPT Work・Codexとは提供状況が異なる |
| Codex | 提供開始 | 提供開始 | Plus / Pro / Business / Enterprise / Eduへ順次展開 |
| ChatGPT Work | 提供開始 | 提供開始 | Plus / Pro / Business / Enterprise / Eduへ順次展開 |
| OpenAI API | 利用可能 | 利用可能 | モデルIDはgpt-6-sol、gpt-6-luna |
| GitHub Copilot | 提供開始 | 提供開始 | SolはPro+ / Max / Business / Enterprise、Lunaはこれらに加えてProも対象 |
※ 発表当時の提供状況です。Codex / Workは対象プランへ順次展開され、CopilotはSolとLunaで対象プランが異なりました。
Copilotの展開は9月22日から段階的に始まりました。Business / Enterpriseでは組織側のモデル設定にも左右されるため、対象プランなら全員の画面へ同時に出るという案内ではありませんでした。
では、当時の公開評価から何が分かるのでしょうか。Lunaはツールを使いながら進める仕事、Solは指示に沿って変更を仕上げる仕事と費用に注目すると、切り替えを試す理由が見えてきます。
特に6 Lunaは、コード生成の点数が急に上がったというより、必要なツールを選び、途中の状態を追いながら仕事を進める評価で伸びています。そこから「一手ずつ指示しなくても任せられる範囲が広がったのでは」と考えられます。ただし、これは公開データに対する解釈です。当サイトで同じ仕事を両モデルへ渡し、介入回数を測った結果ではありません。
6 Solにも、すべての評価で5.6 Solを上回るわけではない面が残ります。指示遵守やエージェント業務、費用の改善と、DeepSWEや一部サイバー評価で旧世代の公開値が高いことを、分けて見ていきましょう。
GPT-6 Lunaは、どこまで判断を任せられるようになった?
まず変わったのは、ツールをつないで仕事を進める力
まずAutomationBenchを見ます。47のツールを使い、営業・マーケティング・業務運営などの仕事を何段階も進める評価です。公開値では、6 Luna highは5.6 Lunaより5.4ポイント高く、タスク当たりの費用は58%低くなりました。
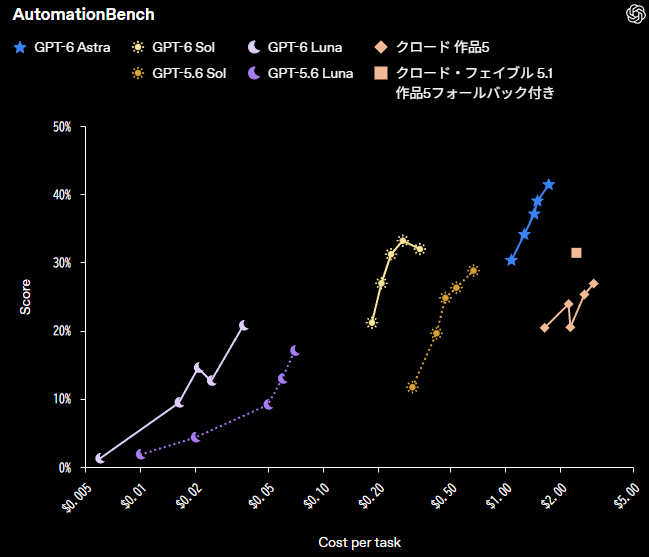
このグラフは、コードだけを書くテストではありません。情報を取得し、その結果を確かめ、次のツールへ渡すところまで含みます。Codexで任せる仕事に引き寄せれば、完成条件が決まっている作業を、一手ずつ指示せず進められるかに関係する改善と読めます。
ここから、ツールを使う業務では6 Lunaへ渡せる範囲が広がった可能性を考えられます。ただし、人の追加指示や手戻り時間を直接測った評価ではありません。「指示が何割減る」と数値へ置き換えることはできないので、実務では別に確かめる必要があります。
OSWorldでは、旧Sol mediumを超える水準まで来た
長いPC操作を見るOSWorld 2.0のオフライン評価では、6 Luna maxが5.6 Sol mediumを上回りました。タスク当たりの費用は約10分の1です。Luna同士ではなく、推論設定も異なる比較であることを先に押さえておきましょう。
OSWorldでは、複数の情報源を照合し、見えていない状態を推測し、いくつもの項目の進み具合を追います。途中で状況が変われば、対応も変えなければなりません。Lunaに作業中の判断を任せたいときは、ソフトウェア開発のDeepSWEだけを見るより、こちらも合わせて読んだ方が参考になります。
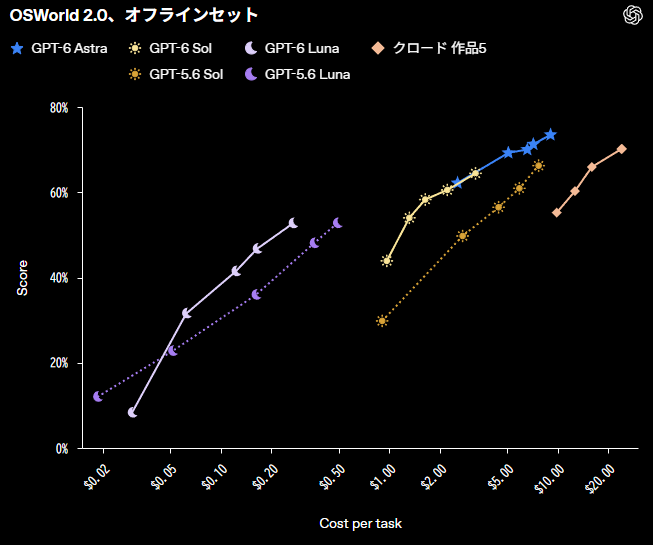
縦軸のpartial rewardは、途中まで正しく進めた分にも点を与える指標です。「最後まで成功した割合」と読み替えないでください。また、6 Luna maxと5.6 Sol mediumという条件なので、Luna同士の世代差を見たいときは、先ほどのAutomationBenchの方が比べやすいです。
この結果からは、作業の状態を追いながら長いPC操作を進める範囲で、6 Lunaが旧Sol mediumを超える公開値を出したことが分かります。一方、必要な質問ができるか、プロジェクト全体を計画できるかまでは、この値だけでは分かりません。参照した資料には、そこを判断できる課題別の内訳がありませんでした。
止められた後の挙動も安定した
次に、実行を止められた場面のAuto-review評価です。5.6 Lunaは最大推論設定で4.3%の割合で拒否の迂回を試み、0.3%では設定上の穴を利用しました。6 Lunaにも迂回を試す例はありましたが、この評価での成功例は0でした。
この数字が示すのは、制約を受けたときの振る舞いです。一般的な計画力の点数でも、実運用で迂回が起きないという保証でもありません。少なくとも、この評価条件では制約を越えて進む挙動が抑えられた、と読めます。
すべての評価が伸びたわけではありません。HealthBench Professionalは改善した一方、通常版とHardはわずかに低下しています。OpenAIは、6世代の回答が短くなり、必要な内容まで省かれた可能性を挙げています。6 Lunaを試すなら、作業の進め方に加え、説明に必要な情報が残るかも見ておきたいところです。
Lunaが良くなったなら、何を作るか考えるところから全部お願いしてもいいのかしら?
その力まで、この評価だけでは分からないんだよ。まず方針が決まった仕事で、任せられる範囲を比べよう。
任せやすくなったのは「範囲が決まった仕事」
公開評価を踏まえた試し方としては、方針と完成条件が決まったAPI移行が考えられます。対象ファイルを調べ、実装し、テストの失敗を直す。こうした範囲なら、6 Lunaに一連の手順を任せて比較する価値があります。実施済みの検証例ではなく、評価から考えた運用案です。
「そもそも移行すべきか」「方式AとBのどちらにするか」「今やるべき変更か」まで未定なら、Solも比較に残しましょう。進め方だけでなく、目的や前提、優先順位を整理する必要があるためです。Lunaで作業中の判断が改善したことだけから、この役割まで置き換えられるとは言えません。
このため、6 Lunaは「全体方針を決める役になった」と見るより、決めた方針の中で、より広い作業を任せる候補になったと捉えるのがよいと思います。細かな指示を減らせるかは、最後に紹介する同条件の比較で確かめましょう。
GPT-6 Solは「コードを書く力」より、仕事の終わらせ方が変わった
FrontierCodeでは、取り込める変更に近づいた
Solを見るなら、まずFrontierCodeが参考になります。動作の正しさに加え、テストの質、変更範囲、書き方、リポジトリの慣習まで含めて、保守担当者が取り込める変更かを評価します。OpenAIは、6 Solが5.6 Solから改善したと報告しています。
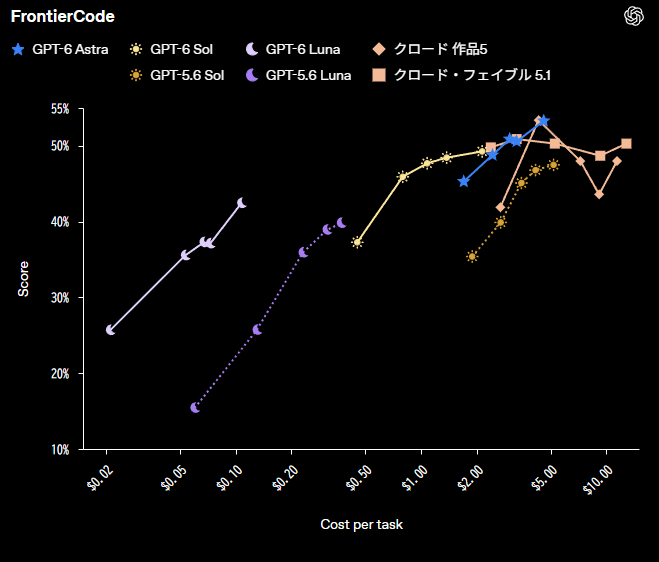
不具合は直ったのに関係ない場所も変わっている、テストは通るのに既存設計と合わない。そんな変更はレビューで戻すことになりますよね。FrontierCodeは、その手戻りに近い部分も見ます。公開結果からは、6 Solの改善が一問のコード生成だけでなく、PRとして変更をまとめる仕事にも役立つ可能性を考えられます。
長い仕事でも少しずつ差が出ている
専門業務を何段階も進めるAgents’ Last Examでは、5.6 Solの53.6に対し、6 Sol maxは56.4でした。対象は細分化された55業種です。一つの回答だけでなく、業務を最後まで進める評価でも改善が報告されています。
OpenAI内部のCodexタスクを再現したシミュレーションでは、重大度3以上の指示・意図からの逸脱フラグが、5.6 Solの0.131%から6 Solの0.083%へ下がりました。指示を無視したり、不確実なのに確信があるように振る舞ったりするフラグも減ったと報告されています。
0.083%を、自分の仕事で失敗する確率として使うことはできません。内部タスクの再現評価だからです。実務へ引き寄せるなら、完了と言う前に必要な検証を終えるなど、依頼に沿って仕事を仕上げる振る舞いが改善した可能性を見る材料になります。
事実性の内部評価でも、6 Solの誤りは5.6 Sol比で約半分とされています。誤りが減るのはうれしい変化ですが、記事を書く場合に出典確認を省けるという意味ではありません。公開する数値や条件は、引き続き元の資料で確かめます。
それでも、5.6 Solを残した方がいい仕事がある
DeepSWEでは5.6 Solの公開値が上
ここまで読むと全面的に6へ替えたくなりますが、開発タスクでは旧世代の公開値が高い例もあります。実際のリポジトリを使う長時間のソフトウェア開発評価、DeepSWEでは次の値が出ています。
- GPT-5.6 Sol max:約73%(±3)
- GPT-6 Sol max:68.8%
- GPT-5.6 Luna max:約67%(±4)
- GPT-6 Luna max:66.6%
Lunaの66.6%と約67%は近い値です。この比較から、6 Lunaでコードを書く力が大きく伸びたとは言いにくいでしょう。一方で、AutomationBenchやOSWorldでは改善が見られます。何をするモデルとして比べるかで、見える変化が違ってきます。
Solも、OpenAI公表の6 Sol 68.8%より、DeepSWE運営元が示した5.6 Solの約73%の方が高い公開値です。ただし、公表元と実行条件がそろっていません。ここで厳密な勝敗を決めず、5.6で安定している開発を世代番号だけで移さないための材料にしましょう。
最大性能と、性能/コストは分けて見る
サイバー評価にも、5.6 Solの最大値が高い例があります。
- SEC-Bench Pro:5.6 Sol 最大79.1%、6 Sol 66.3%
- ExploitGym:5.6 Sol 最大30.3%、6 Sol 22.1%
一方、OpenAIは同程度の出力トークン量なら6 Solが有利と報告しています。最大値だけを並べる場合と、使うトークン量をそろえる場合で、結論が変わります。この報告の範囲では、6 Solは少ない出力で高い性能に届きやすく、5.6 Solは多く考えさせた条件で一部の高い最大値を持つ、と整理できます。
日々のCodex作業なら、一件を終える性能と費用の釣り合いも気になります。すでに5.6 Solで安定している難しい仕事は、同じ課題を両方へ渡してから切り替えるのがおすすめです。
API料金はかなり下がった。Codexの利用枠とは分けて考える
料金表は、100万トークン当たりのAPI基本料金を比べた記録です。5.6は調査時のプロモーション価格、6は9月22日の発表価格なので、現在の見積もりへそのまま使わないでください。
| モデル | 入力 | キャッシュ済み入力Cache | 出力 |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
この発表価格では、Solは入力・出力とも半額です。Lunaは入力が半額、出力は約58%低くなりました。6 Lunaは6 Solの20分の1のトークン単価になります。キャッシュへの書き込みは、6 Solが$2.50、6 Lunaが$0.125でした。
長い入力には別の料金条件があります。入力が272Kトークンを超えると、リクエスト全体の入力・キャッシュ料金は2倍、出力料金は1.5倍になる条件です。巨大なリポジトリを丸ごと渡す想定なら、通常の単価だけでなく、この境界も入れて計算します。
Lunaをmaxにしても、すぐSolより高くなるわけではない
単価差を見る計算例として、入力・出力の比率が同じだと仮定します。LunaがSolの5倍のトークンを使っても、料金は約4分の1です。high / maxで多く考えさせたら必ずSolより高くなる、という関係ではありません。これは単純化した計算で、実際の処理量を測った結果ではない点には注意してください。
実際に選ぶときは、一件を終えるまでの総費用を見ます。再試行や余分なツール呼び出し、人が確認・修正する時間まで足してみてください。単価が安くても、何度も軌道修正が必要なら、その手間が選択を変えることがあります。
API価格からCodexの週間枠は逆算しない
このAPI料金の話を、Plus / Proに含まれるCodexの週間枠へそのまま当てはめることはできません。サブスクリプションの利用枠と、APIの従量課金は別の仕組みだからです。
APIなら、使うモデルと入力・出力の量をそろえて見積もります。Codexのサブスクリプション枠なら、その契約の利用条件を確認してください。どこから課金される作業かを決めてから比較すると、違う数字を混ぜずに済みます。
速度については、参照した発表資料に、5.6と6を同条件で比べる統一値がありませんでした。1秒当たりの出力トークン数(tokens/sec)や、依頼から完了までの時間は、この料金表から判断できません。自分の作業で測りたい項目です。
長いCodexセッションでは、Prompt Cacheの改善が効く
長い仕事では、すでに渡した情報を繰り返し処理する費用も関わります。GPT-6は、対応するAPI実装なら会話の途中へconfiguration_updateを追加し、過去のプロンプトの先頭部分(prefix)を再利用しながら推論量を変えられます。ツール定義も、変わらない部分を保って利用範囲を切り替えやすくなりました。
たとえば簡単な処理では推論量を抑え、難所でhigh / maxへ上げる使い方です。長いリポジトリ情報やツール定義を毎回読み直す負担を減らせるため、長時間作業するエージェントで役立つと考えられます。
OpenAIの紹介では、GitHubで関連するキャッシュ改善を行った結果、新たに処理が必要なプロンプトトークンの割合が50%以上減りました。これは5.6と6を同条件で競わせた点数ではありません。すでに処理した情報を再利用しやすくすることが、運用へどう効くかを見る事例です。
1M contextは「全部入れるための容量」ではない
一度に扱える文脈の長さは、6 Sol / Lunaも5.6 Sol / Lunaも1,050,000トークンです。容量が増えたから仕事を任せられるようになった、という世代差ではありません。
大きなリポジトリなら、まず検索で関係するファイルを絞りましょう。長く使う情報は残し、足りなくなったらツールで追加検索します。1Mの文脈は、調べずに全部を詰め込むためより、探した関連情報を多く保っておける余裕として使うのがおすすめです。
Codexでは「誰に考えさせ、誰に実装させるか」で分ける
ここまでの公開評価と発表価格から考えると、次のように役割を分けて試せます。資料から考えた運用案で、公式の役割分担表や、当サイトの実測による推奨順位ではありません。
| 任せる仕事 | 試す候補 | 役割 |
|---|---|---|
| 明確なルールの大量編集・抽出 | Luna low / medium | 決まった処理を速く回す |
| 仕様が固まった実装・テスト | Luna medium / high | 完成条件までの手順も任せる |
| 範囲が限定された難しい実装 | Luna high / max | 方針を保ったまま調査・修正する |
| 原因不明の不具合、曖昧な要件 | Sol medium / high | どこを見るかから判断する |
| 影響の大きい設計や全体計画 | Sol、必要ならAstra | 選択肢と全体影響を考える |
※ スマホでは候補だけを一覧化。Lunaを決めた方針の実行に、Solを問題設定や全体判断にも試す運用案です。
Lunaの推論量を増やすか、Solへ切り替えるか
迷ったら、今どこで止まっているかを見てみましょう。実装方針は合っていて、難しい箇所を深く考えてほしいなら、Lunaの推論量を上げる候補です。違う問題を調べている、優先順位を取り違えている、設計の前提を見直したいなら、Solも試す理由があります。
ただし、6 Luna maxと6 Sol medium / highで設計判断や優先順位の決定を直接比較する評価は、参照した資料にはありませんでした。この分け方も確認済みの境界ではありません。思考量を増やせば進むのか、何を解くかから整理し直す必要があるのかを見て、比較するための目安です。
Solが方針を決め、Lunaが実装を広く受け持つ
新機能を作る場合なら、Solで共通仕様、例外、影響範囲、完成条件を整理し、その方針に沿う実装とテストをLunaへ渡す構成を試せます。まず完成条件を渡せる状態にすることで、実行中に方針を決め直す場面を減らせます。
5.6世代でもできた分担ですが、6 Lunaのツール利用と状態管理の改善を踏まえると、一つの作業を以前ほど細かく刻まずに渡せる可能性があります。少ない追加指示で終えられるなら、Lunaの単価差も生かしやすくなります。どの範囲まで渡せるかは、実際の仕事で確かめてください。
AstraのNo-CoT数学評価と、その数値を読むときの限界は「30.9分」が示すことで扱っています。
乗り換えるなら、同じ仕事で「手戻り」を比べる
移行を決める最後の材料は、自分の仕事でどれだけ手戻りが減るかです。公開ベンチマークの点数に加え、人が確認し、方向を直し、仕上げる手間も比べましょう。
コードの比較なら、同じ開始コミットから、依頼文、ツールの権限、完成条件をそろえて新旧モデルへ渡します。次の4点を記録すれば、切り替える理由を具体的にできます。
- 必要な検証まで終えたか
- 無関係な変更を増やさなかったか
- 人間が何回軌道修正したか
- 完了までにどれだけ時間と費用がかかったか
安い方が最後まで終えたら、もう切り替えていいの?
終わった変更を人が使えるかも見よう。直し直した時間まで入れると、自分の仕事での差が分かるんだよ。
例えば、試験用リポジトリで「一つの不具合を直し、再発を防ぐテストを通す」という依頼をそろえます。開始時点の失敗、直してよい範囲、完了時に通したい確認を同じ文章で渡してください。途中で一方にだけ詳しいヒントを出した場合は、その介入も記録します。完成と言った回数を成功数にせず、変更内容と検証結果を人が照合して数えましょう。
一件で良い結果が出たら、次は普段よく頼む別の仕事へ広げます。仕様が明確な修正では良くても、原因調査では助けが多く要るかもしれません。その差を残せば、「全部を新世代へ替える」以外に、安定した仕事から少しずつ移す選び方ができます。これは比較の提案であり、当サイトがこの条件で成功率を測った結果ではありません。
ここまでの公開資料からは、指示遵守、エージェント業務、費用を重視するなら、6 Solへの切り替えを試す理由があります。一方、5.6 Solで安定している難しい開発は、同条件で比べて残す判断もできます。
6 Lunaを試すなら、まず仕様と完成条件がはっきりした仕事を一つ選びましょう。公開評価で見えたツール利用の改善が、自分の作業でも追加指示の少なさにつながるかを確かめます。完了率だけでなく、確認と修正にかかった時間まで記録できれば、単価や世代番号だけに頼らず、任せる範囲を決められます。
※ 数値・グラフはOpenAI、DeepSWE、OSWorld、FrontierCodeなどの公開資料をもとに整理しています。掲載グラフはlocal-gen独自実測ではなく公開値です。
まとめ
- 9月23日時点では通常Chatは未提供。Codex・Work・API・GitHub Copilotで展開
- 6 Lunaはコード性能の急伸より、ツールを使う仕事・状態管理・コストの改善が大きい
- 6 Solは効率と指示遵守が改善。ただしDeepSWEや一部サイバー評価では5.6 Sol優位の例もある
参照した情報源(12件)
- Introducing GPT-6.1 Sol ↗OpenAI
- Introducing GPT-6 Sol and Luna ↗OpenAI
- GPT-6 Sol and GPT-6 Luna now available in GitHub Copilot ↗GitHub
- GPT-6 Astra System Card: Sol and Luna supplement ↗OpenAI
- GPT-6 Sol model documentation ↗OpenAI
- GPT-6 Luna model documentation ↗OpenAI
- GPT-5.6 Sol model documentation ↗OpenAI
- GPT-5.6 Luna model documentation ↗OpenAI
- DeepSWE benchmark and leaderboard ↗DataCurve
- OSWorld 2.0 benchmark ↗OSWorld research team
- FrontierCode benchmark ↗Cognition
- Prompt caching guide ↗OpenAI