ローカルAI・PC実践ガイド
LM Studioのコンテキスト長を決める方法|資料と返答が収まる設定にする
目次
LM Studioで長い資料を読ませたいときは、コンテキスト長を確認します。これは、資料や会話履歴、これから作る返答を含めて、一度に扱える文章の長さです。
長く設定すれば入れられる文章は増えますが、必要なメモリも増えます。まず使いたい資料が収まる長さを考え、モデルの設定を変えてみましょう。
モデルには128Kって書いてあるのに、設定は8192です。どっちを見ればいいんですか?
128Kはモデル側の上限、8192は読み込むときの設定だよ。資料と返答が収まる長さにして、読み込み直そう。
資料だけでなく、返答の分も残す
コンテキスト長の単位はトークンです。文章を細かく区切った単位で、日本語の文字数とは一致しません。トークン数は、使うモデルのトークナイザー(文章をトークンに分ける仕組み)やアプリの表示で確認します。
たとえば、資料が6,000トークン、指示と会話履歴が1,000トークン、返答に2,000トークン必要なら、合計は9,000トークンです。8,192では足りないので、資料を絞るか、16,384など余裕のある長さを候補にします。
「128K対応」のモデルなら、その上限の範囲内で資料と返答に必要な長さを設定します。短い会話では小さく始め、増やすときはモデルの対応上限までに収めましょう。32Kまでのモデルも、設定の上限は32Kを基準にします。
PDFなどを検索して関連部分だけ渡す場合は、その部分の量で考えます。元のPDFが何ページあるかより、質問と一緒にモデルへ渡る文章の長さが重要です。
My Modelsからコンテキスト長を変える
- 返答やAPIの処理を終えて、使っているモデル名・量子化・現在のコンテキスト長を控えます。
- LM Studioの「My Models」を開き、使うモデルの歯車アイコンを押します。
Context Lengthを変更します。上の計算例で16Kを試すなら、16384を指定します。まずGPU Offloadなど、ほかの設定はそのままにします。- 設定を保存し、対象モデルを読み込み直します。チャットのモデル設定に
Reload to apply changesが出ていれば押し、読み込みが終わるまで待ちます。 - 同じモデルの設定を開き、
Context Lengthが指定した数値になっているか確かめます。
モデルごとの既定値は、次の読み込みから使われます。数値の保存と、読み込み直す操作を続けて行いましょう。LM Studio公式のモデル別設定でも、My Modelsの歯車と次回読み込みへの反映を案内しています。
次の実画面では、上段のContext Lengthが8192、その下のModel supports up toが131072です。設定するのは上段の数値です。
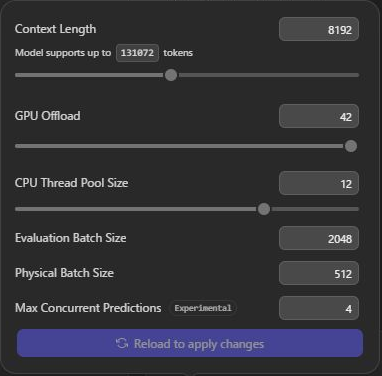
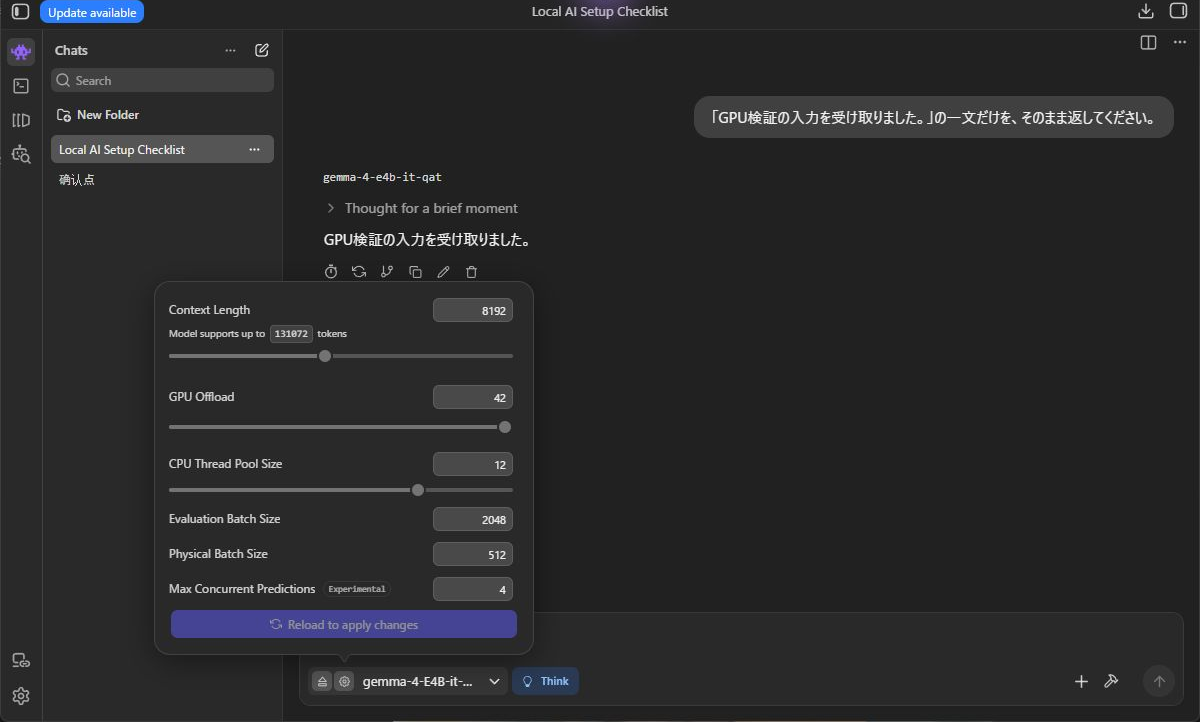
読み込めたら、設定画面を閉じて資料を試しましょう。メモリ不足で読み込めない場合は、いったん以前の値へ戻します。必要なメモリを先に調べたい場合には、記事末尾のコマンドを使う方法もあります。
使いたい資料で質問してみる
読み込めたら新しい会話を開きます。まず、次のような短い入力例で、返答まで進めるかを確かめましょう。
次のメモから、担当者と期限を二組とも抜き出してください。
田中さんは11月12日までに案内状を作ります。
佐藤さんは11月18日までに会場を予約します。
原文と照合するのは「田中さん・11月12日」と「佐藤さん・11月18日」の二組です。名前と日付の組み合わせが残り、返答が最後まで出たら、普段使いたい資料へ進みます。
資料の前半と後半から、答えを確かめられる箇所を一つずつ選びます。別の日付があるなら、「それぞれの日付を、根拠の文と一緒に答えてください」と尋ねてみましょう。長さの変更前後を比べる場合は、モデル・資料・質問をそろえ、どちらも新しい会話で試します。
前半と後半の答えがそろい、返答が最後まで出れば、用意した長さで資料を扱えています。あわせて待ち時間を見て、普段使える設定かを決めましょう。
| 困ったこと | 試すこと |
|---|---|
| 入力が長すぎる | 古い会話を要約する、関係のない資料を外す、コンテキストを増やす |
| 読み込みでメモリ不足になる | 以前の長さへ戻す、ほかのモデルやアプリを終了する |
| 返答が途中で切れる | コンテキストに返答の分が残っているかと、回答の出力上限を確認する |
| 返答は出るが内容が違う | 必要な原文をモデルへ渡せているか、原文を正しく読み取っているかを確かめる |
長くした途端に遅くなった場合は、会話の計算結果を保存するKVキャッシュなどが増え、GPUに収まらなくなっている可能性があります。必要な資料を絞るか、少し短い設定へ戻してみましょう。
資料から必要な答えを得られ、待ち時間にも無理がなければ、その長さをモデルの既定値にして使ってみてください。
補足:読み込む前にメモリを見積もる
16Kに増やすと読み込めない場合や、32Kも試せるか調べたい場合は、LM Studioのコマンドlmsで必要なメモリを見積もれます。lmsがまだ使えなければ、公式のCLI導入手順を済ませてください。ターミナルで次を実行し、使うモデルのキーを調べます。
lms ls次のMODEL_KEYを一覧に出たキーへ置き換え、16Kでの見積もりを出します。
lms load --estimate-only "MODEL_KEY" --context-length 16384表示されるのは、指定した文脈長でのメモリ見積もりです。OSやほかのアプリの分も残せそうなら、--estimate-onlyを外して読み込み、実際の使用量と返答を確かめます。
lms load "MODEL_KEY" --context-length 16384小さい設定と比べたい場合は、16384を8192へ変えて見積もってください。GPUへ載せる量など、ほかの設定は同じにしておくと、長さを増やすために必要なメモリが分かりやすくなります。lms loadの公式説明にも、見積もりと読み込みの手順があります。
まとめ
- コンテキストには資料だけでなく指示・履歴・返答も含める
- My Modelsの歯車から変更し、次の読み込みで反映する
- メモリが心配ならlms load --estimate-onlyで見積もり、使いたい資料への返答も確かめる
参照した情報源(4件)
- Per-model defaults ↗LM Studio
- lms load ↗LM Studio
- KV cache strategies ↗Hugging Face
- local-gen — 同一Gemma4 E4B QAT Q4_0のCPU/CUDA実行先とGPU割当の限定記録 ↗local-gen.jp
公式サイト
LM Studio
各リンクから、配布元のファイルや説明を開けます。