開発解説
ループ型Transformerとは?同じ層を繰り返して計算を深くする仕組み
目次
同じ3Bのモデルなのに、片方には「22層を2周する」と書かれている。モデルを選ぶとき、何を二度使うのか、メモリも二倍必要なのかと迷うところです。
同じところをもう一周するの? それって、モデルが二個分になるのかしら。
重みは同じものを使うんだよ。でも、もう一周する計算には時間がかかる。容量と計算の回数を分けて見てみよう。
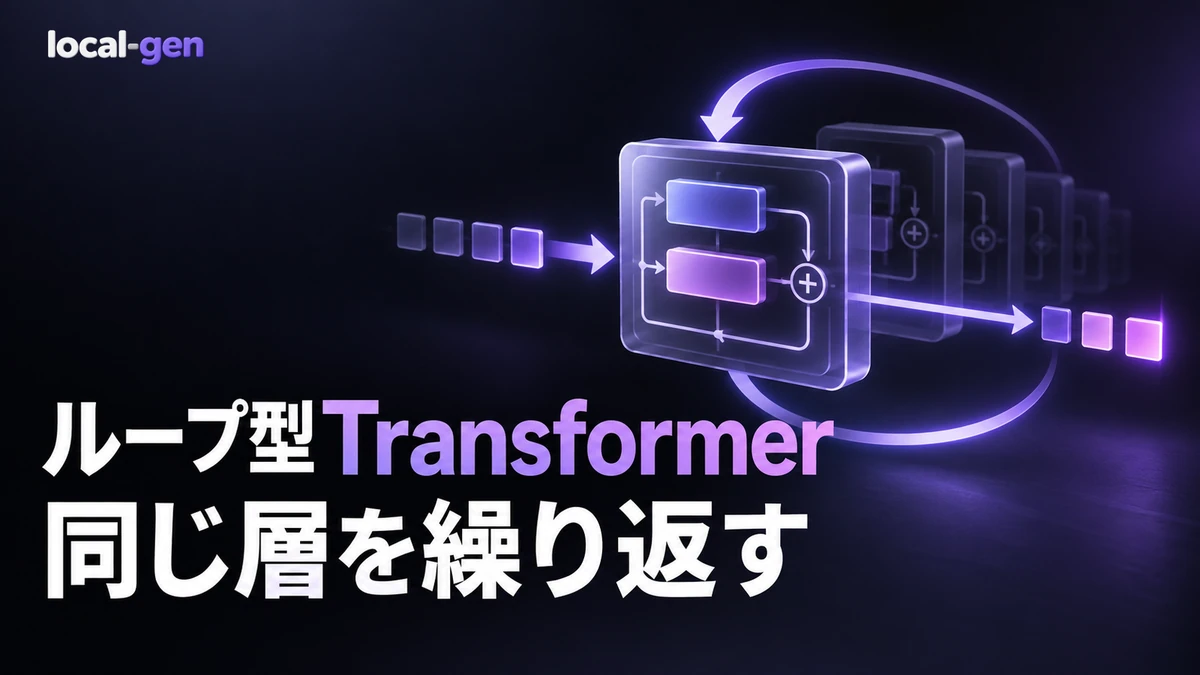
ループ型Transformerは、同じTransformer層や層のまとまりを繰り返し使い、重みを増やさずに計算を深くする設計です。「再帰的深度」と呼ぶ資料もあります。仕組みが分かると、モデル名の「何B」だけで動作の軽さを決めにくい理由も見えてきます。
まずは4層のモデルで考えてみましょう。その4層を2周するなら、保存する固有の層は4層のままです。一方、入力から出力までには、合計8回の層計算を行います。同じ層を再利用するため、保存するものと実行する計算の回数を分けて考えます。
同じ重みを何度も使う
Transformerの層には、入力を次の表現へ変換するための重みがあります。通常の4層構成を単純化すると、それぞれ違う重みを持つ層を一度ずつ通ります。
入力 → 層1 → 層2 → 層3 → 層4 → 出力同じ4層を2周する構成では、最初の4層を通ってできた内部表現を、もう一度同じ層へ渡します。
入力
  → 層1 → 層2 → 層3 → 層4
  → 層1 → 層2 → 層3 → 層4
  → 出力
2周目に別の4層を用意するわけではありません。1周目と同じパラメータを使い、変化した内部表現へもう一度計算を適用します。重みを保存する容量は抑えながら、答えに至るまでの計算の段数を増やせる、という関係です。
パラメータ数と計算量は別の数字
保存するものを増やさずに済むのは魅力ですが、もう一周する演算は必要です。モデルの容量を知りたいときと、応答を待つ時間を知りたいときでは、見る数字を変えましょう。
| 見る項目 | 一般的なTransformer | ループ型Transformer |
|---|---|---|
| 計算を深くする方法 | 異なる層を追加 | 同じ層を再利用 |
| 保存する重み | 層を増やすと増える | 繰り返す部分は共有 |
| 層の実行回数 | 固有レイヤー数に近い | ループ回数でも増える |
| 推論時間 | 層数などで変わる | ループ回数でも増える |
例えば3B同士なら重みの規模は近くても、文章を処理する単位である1トークンを出すまでの計算量はそろわないことがあります。「B」はパラメーター数の単位なので、そこに速度までは含まれていません。MoEで全体の規模と一度に使う部分を分けて見るのと同じように、ループ型では同じ重みを何周するかも確認します。
長い思考文を出す方法との違い
「考える時間を増やす」と聞くと、画面に長い思考文が流れる推論モデルを思い浮かべるかもしれません。途中の文章を順に生成する方法では、その生成に追加の計算を使います。
ループ型では、追加の計算をモデル内部の数値表現へ使えます。何十行もの文章を外へ出す代わりに、内部表現に同じ層の処理を繰り返すわけです。ただし、その数値をそのまま人間の頭の中の独り言のように読むことはできません。二つの方法を単純化すると、次のように描けます。
文章として考える方法:
問題 → 中間文 → 中間文 → 答え

ループ型:
問題 → 内部表現 → 反復計算 → 反復計算 → 答え
Huginnは3.5Bのまま推論時計算を増やせる
Huginnの論文では、再帰的深度を使う3.5Bパラメータの研究モデルを、800Bトークンで学習しています。推論時には、同じ再帰部分を使う回数を変えられます。
面白いのは、保存するモデルを取り替えなくても、問題に割り当てる計算を増やせるところです。追加の反復によって推論課題の成績が伸びる結果が報告されています。ただし、3.5Bという重みの規模が大きなモデルへ変わるわけではなく、どんな仕事でも同じ伸びが得られるとは限りません。自分の用途へ当てはめるときは、改善した課題と追加計算の量を一緒に見ましょう。
LOTUSは内部表現での推論を高速化した
Microsoft Researchが2026年6月に公開したLOTUSの研究も、内部表現へ計算を割り当てる方法を扱っています。3B規模の実験では、明示的な思考文を生成する方法に近い精度を保ちながら、研究で「思考部分」と定義した待ち時間を、比較対象の約1/6.9〜1/2.5に短縮したと報告しています。
この数字を見て、手元のアプリ全体も6.9倍速くなるとは見積もれません。測ったのは研究条件内の思考部分だからです。それでも、長い文章を一語ずつ生成する以外に、追加計算の使い道があると分かる例です。
Nanbeige4.2-3Bは22層を2周する
配布モデルの設定で確かめたいなら、Nanbeige4.2-3Bが一例になります。公式の設定ファイルには、層数と繰り返し回数が次のように書かれています。
num_hidden_layers: 22
num_loops: 2
標準設定は22層分の重みを持ち、そのまとまりを2回実行します。単純化すれば22層分を保存し、44回のデコーダー層計算を行う構成です。「3Bならいつもの3Bと同じくらい速いはず」と考える前に、この設定も見ておくと、違いの理由を探しやすくなります。
VRAMも重みの量だけでは決まらない
重みを使い回すなら、空いてるVRAMに入れば安心……とはいかないの?
動かす間の作業場所も必要なんだよ。会話の長さをそろえて、実際の使用量を見てみよう。
推論中には、重み以外に、会話の途中計算を保存するKVキャッシュや一時的な作業領域も使います。文脈長、量子化、ループごとのキャッシュの扱い、実行環境によって必要量が変わるため、ファイル容量をそのまま必要VRAMにはできません。
Nanbeige4.2の実装にも、複数ループを扱うキャッシュ処理や、KVキャッシュを共有する設定があります。何周するかだけで一律にメモリを掛け算するのではなく、その実装がどう保存するかを確認します。モデルを比較するときは同じ会話長・実行環境で、速度と最大VRAM・RAM使用量を測ると、自分のPCで続けて使えるかを判断しやすくなります。
ループ回数を増やせば無限に賢くなるわけではない
回数を増やすほどよくなるなら、待てる限り回したくなりますよね。ただ、モデルは追加の反復を役立てるように学習されている必要があり、学習時に想定していない回数での挙動もモデルごとに違います。普通のTransformerを学習後に二周させるだけで、同じ効果が出る仕組みでもありません。
繰り返し回数を調整できるモデルでも、まず公式が想定した範囲を確かめます。その範囲で、普段の課題に役立つ設定を探していきましょう。
じゃあ、二周にした方が答えがよければ、そっちを選べばいいのね?
待てる時間も一緒に見よう。毎回使う質問で、増えた時間に見合う違いがあるかを比べるんだよ。
例えば、いつも使う要約を一つ選び、必要な項目を先に決めます。人物名、結論、次の作業がそろうかを見れば、文章が長くなっただけの変化と、役立つ改善を分けられます。回数を変えられるモデルでも、最初は公式の標準設定でこの課題を通してから、対応する範囲で一項目ずつ変える方が違いを追いやすいです。
比較の記録には、モデルと量子化、入力文、会話長、繰り返し回数、回答を待った時間、最大VRAM・RAMを残しましょう。読み込みで失敗したなら、まだ回答の良し悪しを比べる段階ではありません。対応する実行環境かを先に確認し、速度が遅いときはメモリ使用量も照らします。ループ回数だけを原因に決めると、別のボトルネックを見落とすためです。ここでは、その測定を実施した結果ではなく、手元で選ぶための比較方法を示しています。
「何Bか」に加えて何周するかを見る
次にループ型モデルを見かけたら、まずモデルカードと設定ファイルを開き、次の項目を探してみてください。対応する実行環境がなければ、回数や容量の計算が合っていても、そのまま動かすことはできません。
| 項目 | 確認すること |
|---|---|
| パラメータ数 | 保存する重みの規模 |
| 固有レイヤー数 | 異なる重みを持つ層の数 |
| ループ回数 | 同じ層を何回実行するか |
| 文脈長 | KVキャッシュがどこまで増えるか |
| 量子化 | 重みの容量と精度 |
| 実行環境 | ループ構造へ正しく対応しているか |
| 実測 | 速度とVRAM使用量 |
まず「何を保存するか」、次に「何回計算するか」、最後に「手元でどれだけメモリと時間を使うか」。この順で見ると、重みを共有できる利点を、速さの保証と混同せずに評価できます。上の研究結果は各研究の条件で得られたものなので、自分の用途では実際の回答と待ち時間を確かめて選びましょう。
まとめ
- ループ型Transformerは、同じTransformer層や層のまとまりを繰り返し使い、重みを増やさず計算を深くする設計
- 重みを共有できても、繰り返した分の演算量や待ち時間まで無料になるわけではない
- HuginnやLOTUSでは、長い思考文を出力する方法とは別に、モデル内部へ追加計算を使う研究が進んでいる
- Nanbeige4.2-3Bは22層を2周する重み公開モデルで、3Bという表記だけでは推論負荷を判断できない
- モデルを見るときはパラメータ数に加え、固有レイヤー数、ループ回数、KVキャッシュ、実測速度を確認する
参照した情報源(6件)
- Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach ↗arXiv
- Reasoning with Latent Thoughts: On the Power of Looped Transformers ↗arXiv
- Bridging the Gap Between Latent and Explicit Reasoning with Looped Transformers ↗Microsoft Research
- Nanbeige4.2-3B Model Card ↗Nanbeige LLM Lab
- Nanbeige4.2-3B config.json ↗Nanbeige LLM Lab
- Nanbeige4.2-3B modeling_nanbeige.py ↗Nanbeige LLM Lab